OPEN EXPERIMENTS · 持续更新

用实验理解
AI 工程的取舍。

从模型训练、检索到推理部署,我们用代码和测量回答实际问题:哪些方法有效,效果在什么条件下成立,又如何在自己的数据和设备上验证?

从问题到可复核结果实验过程示意:提出问题、设计对照、运行测试、理解结果。XIAOKE AI LABS / EXPERIMENT NOTESFROM QUESTION TO EVIDENCE让每个结论都有来处123提出问题明确目标与适用场景设计并运行对照记录数据、配置与测量方式理解结果与边界开放代码,保留证据
从问题出发,让方法、数据和结论可以被检查。

从问题出发

找到适合的问题和方法,再查看具体数据、配置与结果。

训练与微调

了解如何准备数据、调整嵌入与重排序模型,并用检索指标判断是否有帮助。

推理与性能

比较量化、部署引擎与并发配置,估算内存和带宽,为单机部署提供参考。

检索与存储

探索多阶段检索,比较向量数据库的召回、延迟与存储成本。

文档与多模态

从 OCR、图像模型微调到跨模态部署,观察不同设备上的效果和限制。

实测能告诉我们什么

结果始终对应具体数据、设备和方法。

加速也要检查输出

GB10 上四个 OCR 样本的模型生成总耗时加速 2.36 倍,贪婪输出一致。计时不含图像读取和预处理,结果不能代表所有文档。

查看 OCR 加速 →

建立自己的对照

模型、数据和硬件都会影响结果。实验记录提供配置和运行方法,帮助你结合自己的任务复测。

浏览实验 →

实验索引

选择感兴趣的方向,进入仓库查看方法、代码、结果与适用边界。
训练、微调与检索

查询和文档的批内对比训练流程中文 Embedding 微调
用查询与相关文档学习对比训练;四组内置数据不证明检索效果提升。
查询和候选文档的相关性评分重排序模型微调
通过查询、文档与相关性标签训练交叉编码器。
向量数据库比较:建立索引、近邻搜索、比较速度与召回向量数据库基准
了解六个数据库的测试方法;历史记录缺少原始结果,不用于产品排名。
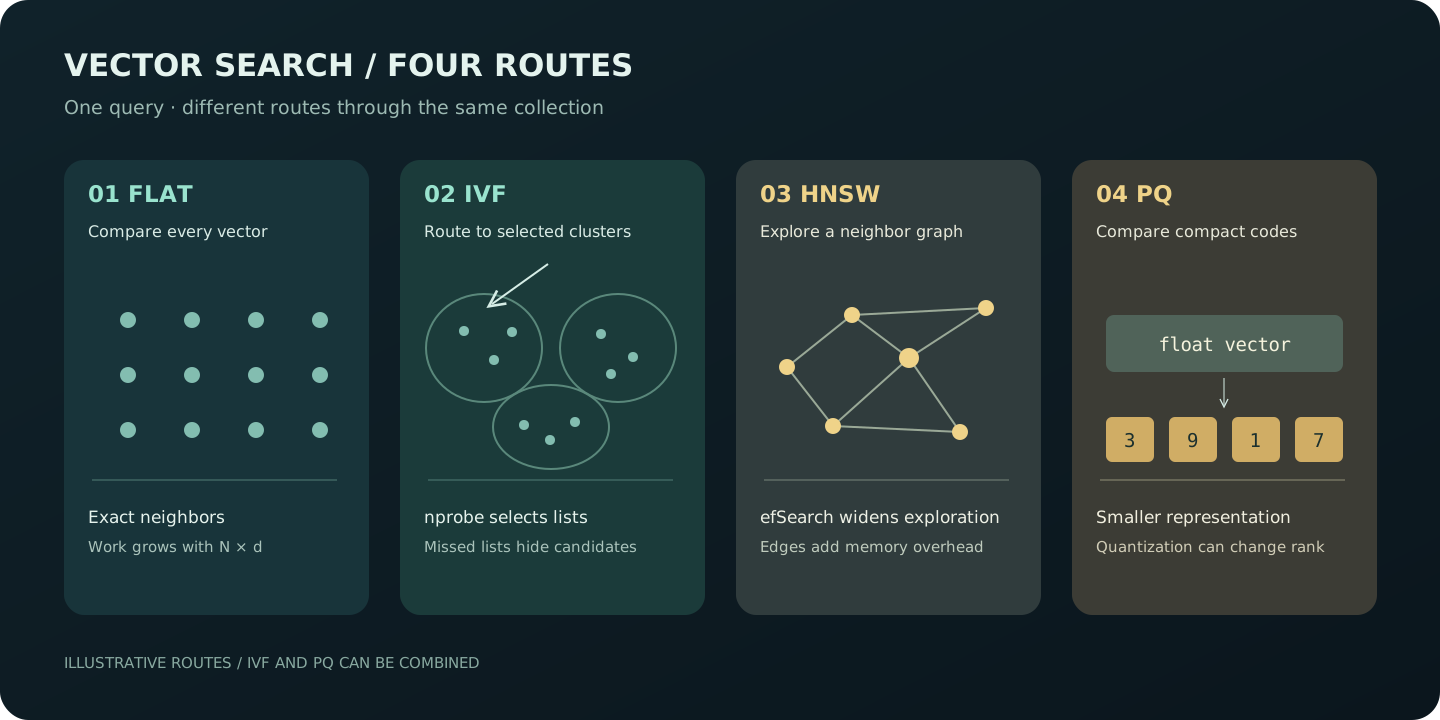
向量索引搜索路径向量索引成本
比较 Flat、IVF、HNSW 与量化索引的召回、耗时和空间。

蒸馏、多模态与微调

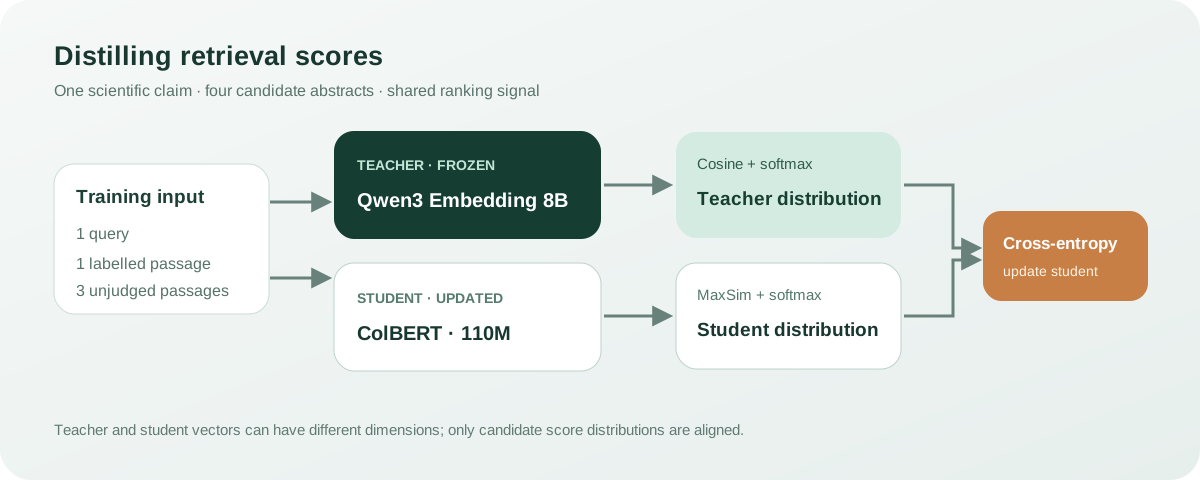
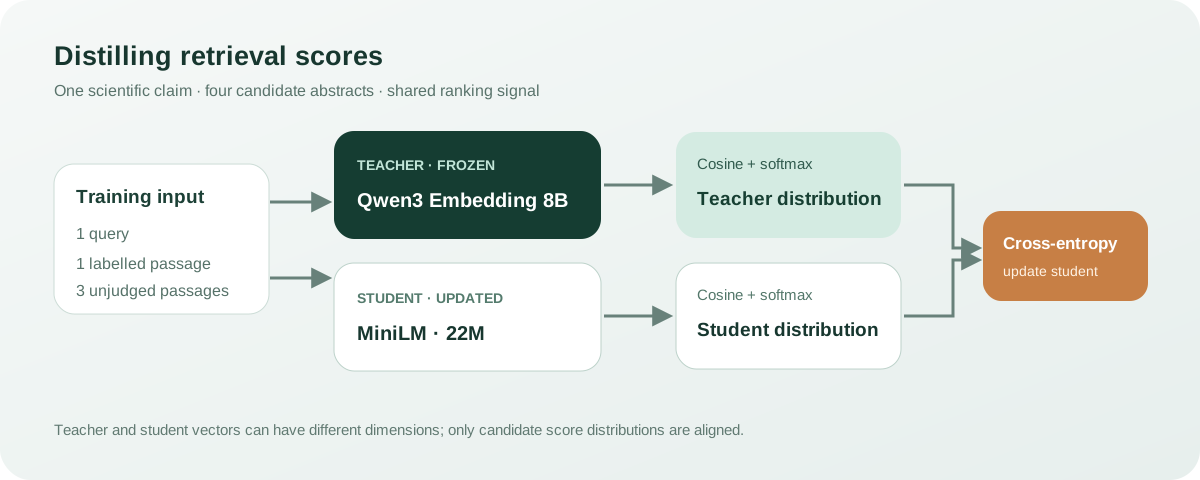
Embedding 蒸馏实验配图Embedding 蒸馏
在 300 条留出查询的固定候选上,蒸馏组 nDCG@10 较原模型高 0.0057,未达到预设的 0.02 目标。
重排序蒸馏实验配图重排序蒸馏
对照监督训练与教师分数蒸馏,了解固定候选上的排序变化。
ColBERT 蒸馏实验配图ColBERT 蒸馏
真实教师复验中蒸馏与监督组差距很小,单种子结果不足以确认优势。
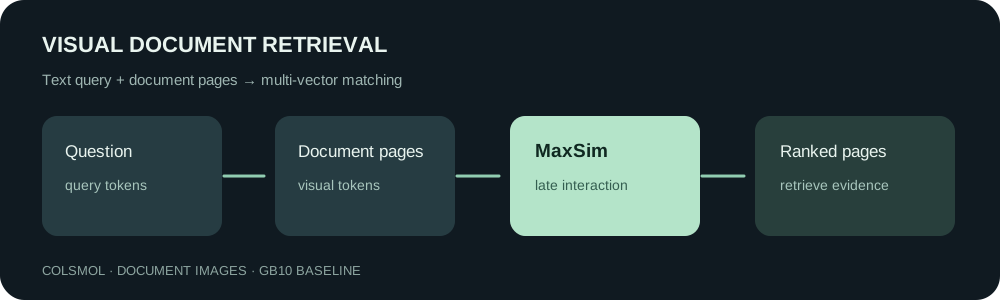
文档图像与问题的多向量匹配视觉文档多向量检索
查看文档页检索基线及合成页面上的微调对照;本次未观察到蒸馏收益。
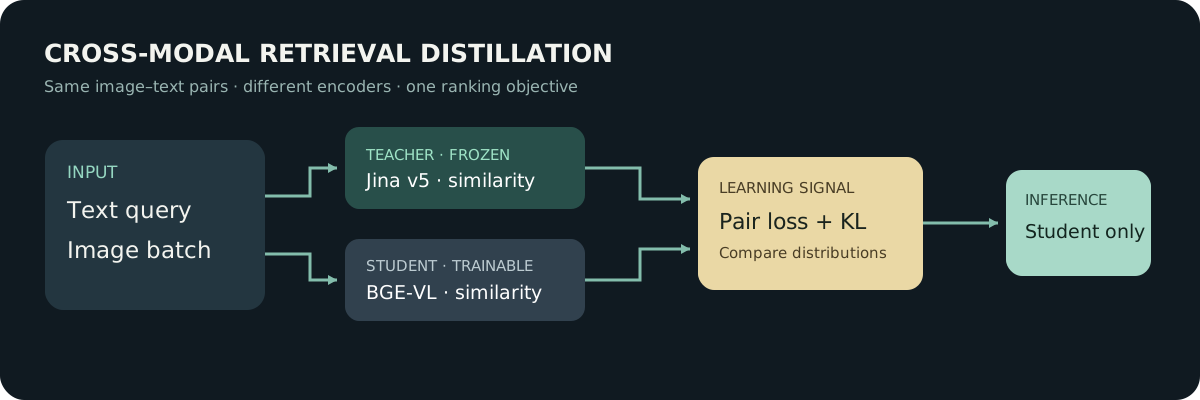
多模态 Embedding 蒸馏实验配图多模态 Embedding 蒸馏
比较图文配对监督与教师蒸馏;100 条测试查询中,蒸馏组 R@1 为 0.91,监督组为 0.93。
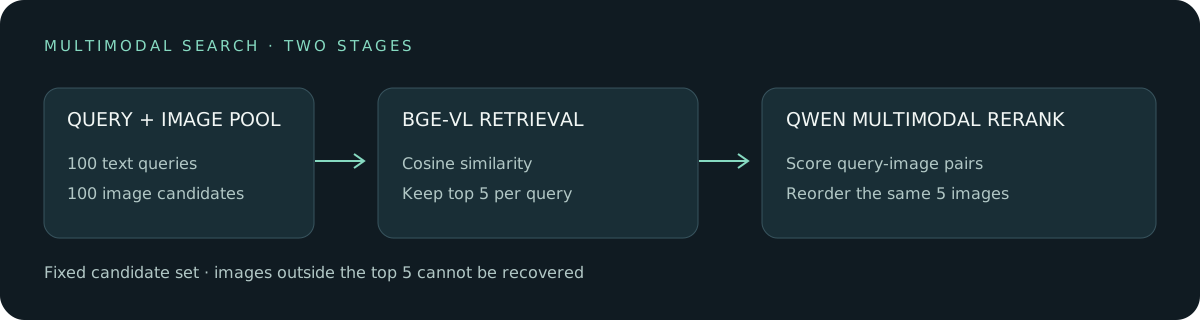
多模态重排序实验配图多模态重排序
探索图文候选的重排序,并查看匿名化评测结果。
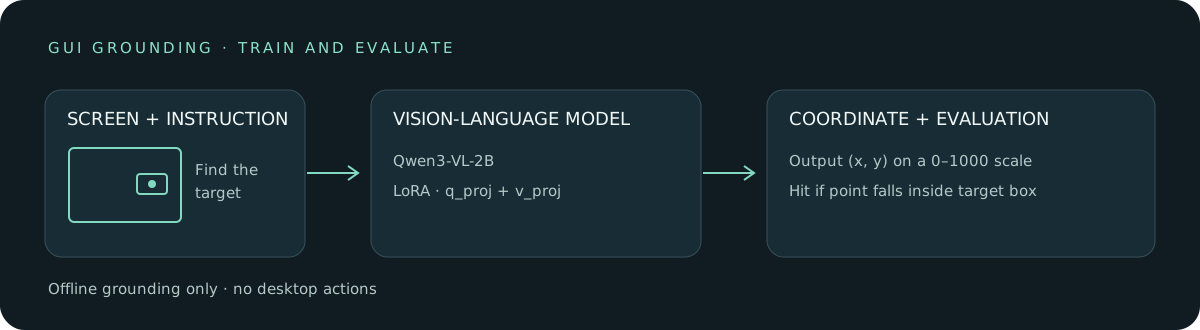
GUI 定位微调实验配图GUI 定位微调
48 条分层留出样本中,基座命中 34、LoRA 命中 42;小样本不能保证跨应用泛化。
水波纹视频生成留出样本的一帧教师视频训练水波纹生成模型
对照教师与学生自产训练素材;小样本抽帧评审未显示教师数据组优于基模。
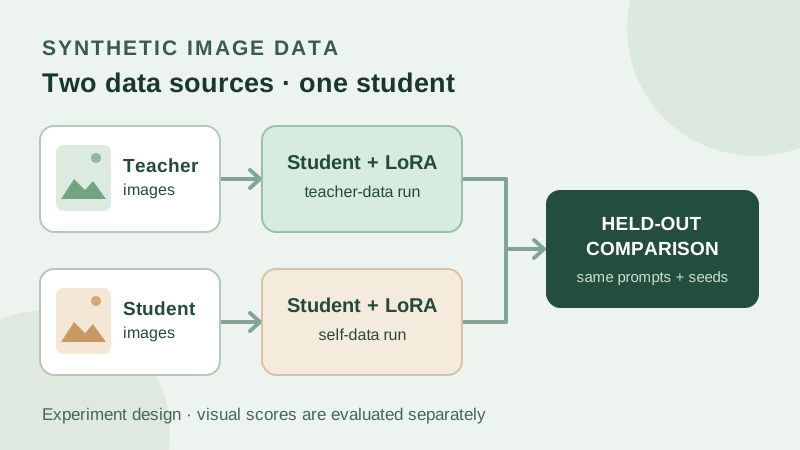
教师与学生自产图像训练数据的对照流程示意合成数据训练文生图模型
教师合成数据微调学生;相机场景的教师优势门槛未通过,陶瓷杯开发集证据已公开,不含模型权重,也不是最终测试;尚不能证明蒸馏成功。
人物图像微调流程示意人物图像生成微调
使用照片训练 LoRA;历史基线与微调结果分辨率不同,不能直接比较。
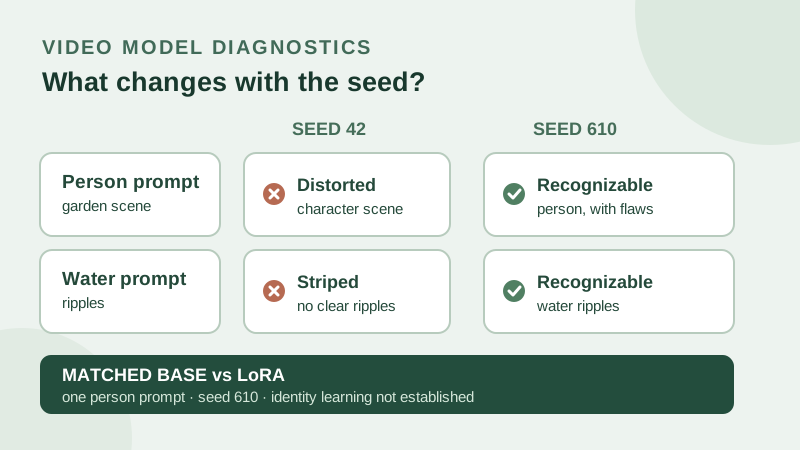
人物和水波提示词的随机种子对照,以及人物基模和 LoRA 对照示意人物视频微调与排障
检查基模、随机种子与 LoRA 输出;留出样本未证明学会目标角色。

推理、部署与成本

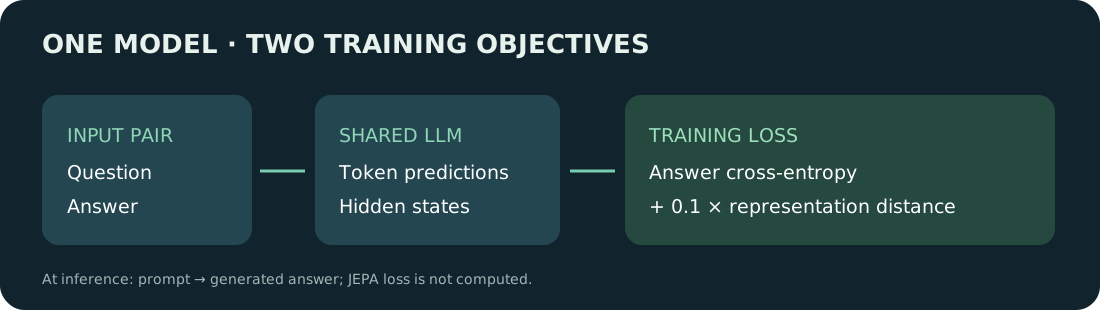
语言模型与 JEPA 训练目标语言模型 JEPA 训练通路
小规模加法对照中,40 道测试题有 21 道与训练题交换顺序后等价;未证明能力提升。
自回归生成与分块扩散生成路径扩散语言模型速度对照
在三道问题上比较生成路径;输出长度和内容不同,不能据此得出等质量加速比。
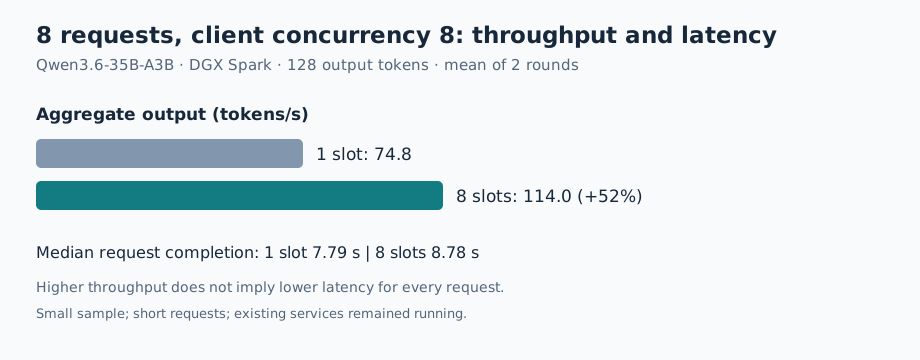
八个并发请求下,单槽平均总吞吐 74.8、八槽 114.0 token 每秒;请求完成时间中位数分别为 7.79 和 8.78 秒,每种配置两轮。GB10 单槽与八槽
同一模型和引擎比较短请求吞吐与完成时间;每档仅两轮。
投机解码流程:提出候选、批量验证、接受或回退LLM 推理性能
对照模型、任务和投机解码配置,理解速度变化。
量化权重、测量体积与比较质量和速度语言模型量化
比较权重体积、小样本困惑度与 CPU 速度;BF16 路径性能异常,不宜推广速度差。
文本生成流程:文本分词、预测下个词元、采样并追加LLM 机制
通过分词、量化、采样与 KV Cache 示例理解推理过程。
从文本到 token 的编码过程Tokenizer 原理
从字节级 BPE 和真实编码器理解分词、上下文与计费。
预填充和增量解码的缓存流程KV Cache 原理
用数值对照观察缓存如何复用历史状态。
推理开销由模型权重、KV 缓存和带宽共同影响推理成本模型
通过内存算例和理论模型理解成本;性能估算尚未经独立验证。
索引流程:组织数据、缩小搜索范围、核对结果数据结构成本
用教学模型探索索引与存储;历史格式记录不能作为选型依据。

文档解析与多模态

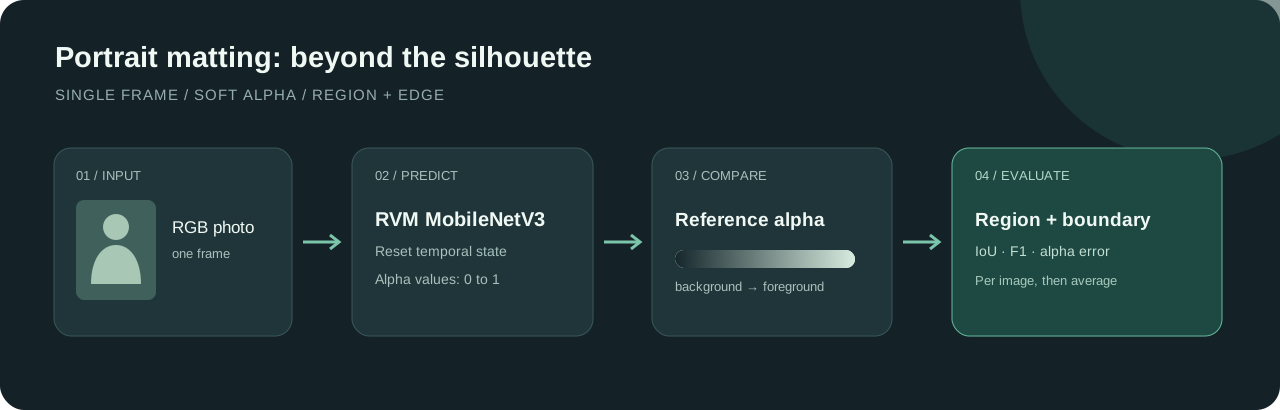
人像抠像模型输出与区域、边界评估流程人像抠像
在 30 张单帧照片上评估主体、边界与推理时间;结果不能代表视频性能。
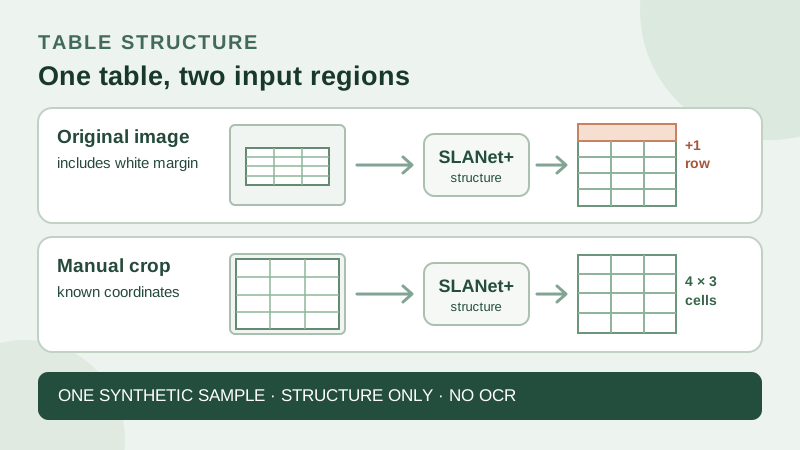
合成表格原图和人工裁剪输入的结构预测对照表格结构识别
用一张合成表格观察裁剪与结构预测;不涵盖文字识别。
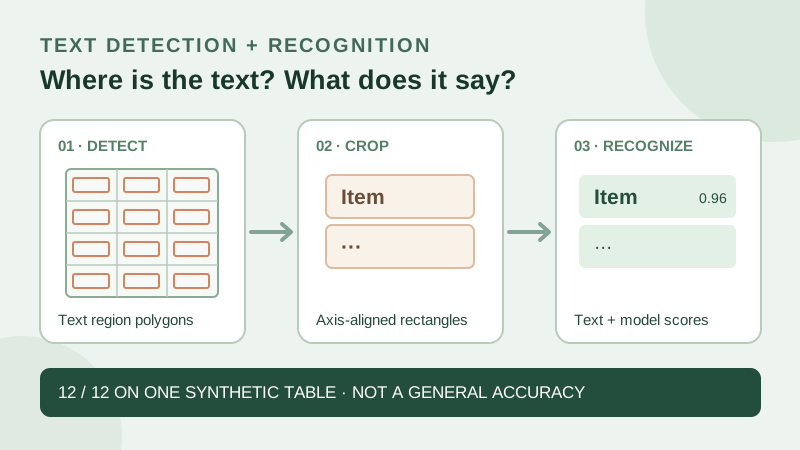
合成表格文字检测、裁剪和识别流程示意文字检测与识别
用两阶段模型定位并识别文字;结果仅覆盖一张合成表格。
四个 OCR 样本中,普通生成总耗时是投机生成的 2.36 倍,不含预处理MiniCPM-OCR
了解文档识别在 GB10 上的部署、质量评估与生成加速。
跨设备部署流程:导出模型、运行 CPU 和 NPU、校验输出Jina CLIP OpenVINO
比较 Intel CPU 与 NPU 的正确性、驱动和特定负载性能。
决策模型流程:输入任务、判别模型输出概率与决策Jev 开源方案评测
比较社区方案的本地部署与小样本决策表现,了解延迟和准确率的边界。